Nvidia פותחת את שרטוטי מפעלי ה-AI לתעשייה
Nvidia פותחת את שרטוטי ה-rack ומגשי החישוב של Vera Rubin דרך ארכיטקטורת MGX, במטרה לפתור צווארי בקבוק בייצור חוות AI. שותפויות חדשות עם Meta, Google ו-Cisco מייצרות תקנים אחידים לרשתות, לקירור ולתוכנה — מהלך שמחזק את הנעילה האקוסיסטמית של Nvidia סביב כל שרשרת הערך.
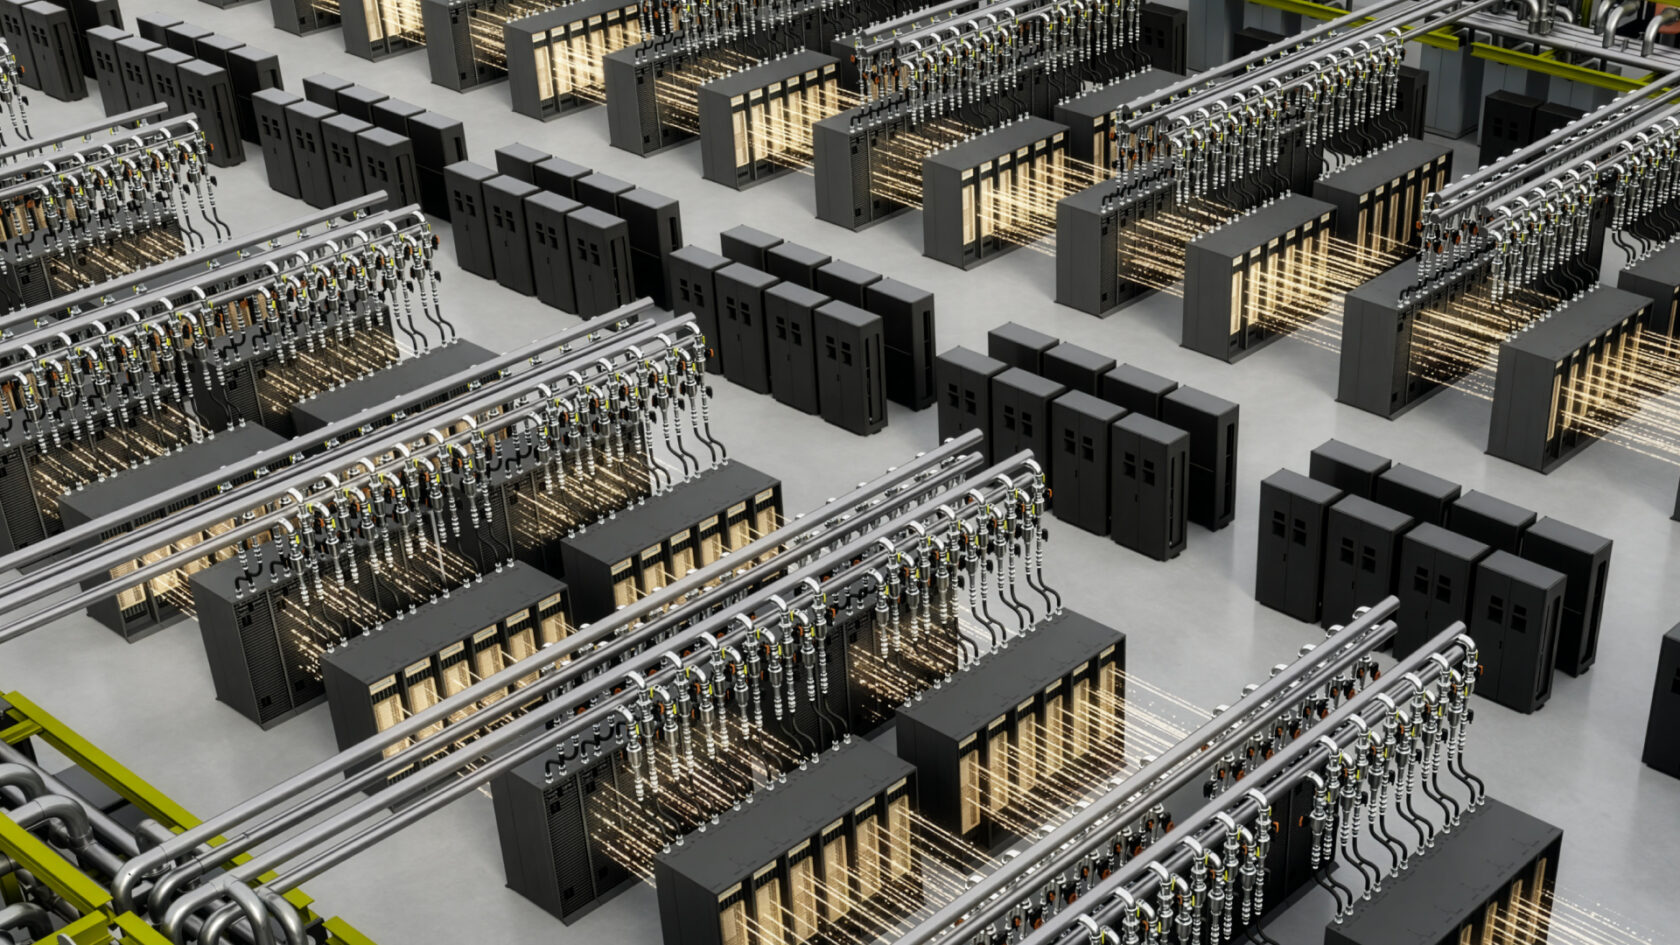
צווארי הבקבוק של מפעלי ה-AI לא נמצאים איפה שחשבתם
כשמדברים על מפעלי AI — אותן חוות ענק שמריצות תהליכי אימון והרצה של מודלי בינה מלאכותית — האינסטינקט הוא לחשוב על כוח מחשוב גולמי. כמה GPUs אפשר לדחוס לתוך כל rack, וכמה FLOPs אפשר לסחוט. אבל ב-Nvidia מפנים את הזרקור למקום אחר: צוואר הבקבוק האמיתי הוא מהירות הייצור והפריסה של התשתיות עצמן.
"צוואר הבקבוק האמיתי לתעשייה כרגע הוא כמה מהר העולם יכול לייצר ולפרוס מפעלי AI", אמר Joe DeLaere, מוביל פתרונות תשתית AI ב-Nvidia. זה לא רק עניין של כסף או סיליקון — זה עניין של תקנים, תיאום בין יצרנים ושרשראות אספקה שפועלות בסנכרון.
בפסגת ה-Open Compute Project (OCP) Global Summit בסן חוזה, Nvidia בחרה להתמודד עם הבעיה הזו מכיוון לא שגרתי עבורה: פתיחת שרטוטים ועיצובים לתעשייה, במקום לשמור אותם קנייניים.
מה בעצם פתחו?
התרומה המרכזית של Nvidia ל-OCP היא העיצובים של rack ה-Vera Rubin ומגשי החישוב שלו, דרך הארכיטקטורה הפתוחה MGX. אם אתם מכירים את ה-MGX — זו הפלטפורמה המודולרית של Nvidia לתכנון חוות מחשוב מואצות, שנועדה לאפשר ליצרנים שונים לבנות מערכות תואמות בלי להמציא הכול מחדש.
העדכון הנוכחי, MGX 1.2, מרחיב את הארכיטקטורה בכמה כיוונים מעניינים:
- קירור נוזלי blind-mate ברמת ה-rack — חיבורים ש"מתלבשים" אוטומטית בלי התאמות ידניות, מה שמקצר משמעותית את זמני ההתקנה בשטח.
- פס צבירה (busbar) מקורר נוזלית ב-5,000 אמפר — מיועד למערכות AI עתירות הספק.
- תמיכה בציוד 19 אינץ׳ סטנדרטי ועיצובים בצפיפות גבוהה יותר.
- מגשי חישוב מקוררים נוזלית ללא מאווררים עם תאי I/O מודולריים וקונפיגורביליים.
הכול נועד לדבר אחד: לקצר את הזמן בין הרגע שמישהו מחליט "בונים חוות AI" לבין הרגע שהיא באמת מריצה מודלים. Nvidia טוענת שהארכיטקטורה הזו תומכת בפריסות rack בהספק של עד 250kW — מספר שמסביר למה צריך קירור נוזלי מלכתחילה.
Vera CPU: הצעד שמאחורי הקלעים
אחד החידושים המעניינים הוא התכנון של ה-Vera CPU rack — פלטפורמה ייעודית שמרחיבה את MGX מעבר לחישוב מואץ. אם ה-Vera Rubin NVL72 נועד לאימון ולהרצה של מודלים גדולים, ה-Vera CPU rack מטפל בצד השני: תיאום, orchestration, קריאות לכלי (tool calling) והרצה בסביבות מבודדות (sandboxed execution).
DeLaere הסביר את זה בצורה ברורה: "בין קריאות למודל, ה-agents צריכים לבצע תיאום. הם צריכים להריץ קוד, לעבד נתונים, להריץ הערכות."
במילים אחרות, בעולם של AI אג'נטי — שבו agents פועלים באופן אוטונומי ומבצעים משימות מורכבות — ה-GPU עושה את העבודה הכבדה של חישוב מקבילי, אבל ה-CPU הוא שמנווט את כל השרשרת. בלי ה-CPU, המערכת מתפרקת.
Nvidia מדווחת שמעבדי ה-Vera שלה מציעים ביצועים גבוהים פי שניים לעומת דור ה-Grace הקודם במבחני ביצועים שונים, ושיפור של פי 1.8 ב-Terminal-Bench — מדד שבודק משימות agent מעשיות בסביבות container.
שותפויות רשת: Meta, Google ו-Cisco
אבל חומרה זה רק חלק מהמשוואה. חוות AI דורשות גם רשתות שמסוגלות להזיז כמויות אדירות של מידע בין אלפי מעבדים במקביל. כאן נכנסות שלוש שותפויות חדשות:
Meta מאמצת את מתג ה-Spectrum-6 Ethernet של Nvidia — שבב switching בקיבולת של 102.4 טרה-ביט לשנייה — לרשתות חוות ה-AI הבאות שלה, שיתחברו ישירות לפריסות Vera Rubin. זה שבב שנועד לטפל בתעבורה מאסיבית, כמו זו שנוצרת כשמפזרים את עבודת האימון על פני אלפי GPUs.
Google ו-Nvidia מרחיבות תמיכה ב-Falcon Transport — טכנולוגיה לניהול יעיל של העברת נתונים ברשתות גדולות. Falcon יודע לנתב תעבורה על פני נתיבים מרובים, להגיב לגודש, לשחזר מנות אבודות ולשמור על חיבורים מאובטחים. התמיכה תגיע תחילה ל-ConnectX-10 SuperNICs העתידיים של Nvidia, ובהמשך גם ל-BlueField DPUs.
Cisco ו-Nvidia מגדירות יחד תקן חדש למודולים אופטיים: Ultra-Dense Small Form Factor Pluggable (USFP) — הפורמט הראשון בתעשייה שמיועד ל-fabrics בקצב 400Gb/s ל-lane. ה-USFP מציע צפיפות רוחב פס גבוהה פי ארבעה לעומת פורמט ה-200G OSFP הקיים, עם שיפור של פי 1.3 ביעילות ההספק.
המשמעות: יותר רוחב פס באותו שטח פיזי, עם פחות חשמל — מה שמאפשר למרכזי נתונים להרחיב רשתות בלי להגדיל את מערכות ה-switching.
תוכנה פתוחה ל-DSX AI Factory
Nvidia גם הרחיבה את ה-DSX OS — שכבת ההפעלה הפתוחה של פלטפורמת DSX AI Factory שלה — עם רכיבי קוד חדשים:
- Config Manager — מגדיר תצורות switch באופן אוטומטי ובהיקף רחב, ומאפשר לפרוס ולתחזק רשתות חוות AI עם מינימום התערבות ידנית.
- Cluster Readiness Engine — מדמה עומסי עבודה אמיתיים באשכולות GPU כדי לוודא שהחומרה תקינה לפני שמתחילים את האימון היקר.
- Rack Management Service — מספק שכבת הפשטה לחומרת rack ופתרונות תפעול.
כלים כאלה נשמעים טכניים, אבל הם מה שמפריד בין חוות AI שעובדת כמו שצריך לבין אחת שמוציאה מיליונים על debugging חומרה אחרי שהאימון קרס.
אז מה המשמעות?
Nvidia נמצאת היום במצב מעניין: היא לא רק מוכרת שבבים — היא מנסה לתכנן את כל שרשרת הערך של מפעלי AI, מהסיליקון ועד הקירור, מהמתג האופטי ועד לתוכנת הניהול.
פתיחת העיצובים ל-OCP היא צעד טקטי חכם: ככל שיותר יצרנים יאמצו את התקנים האלה, כך גדלה הנעילה האקוסיסטמית סביב Nvidia. אם כל ה-racks, הקירור, הרשתות והתוכנה מתוכננים סביב MGX ו-Vera Rubin — מי שרוצה לחרוג מהתקן הזה משלם על כך ביוקר.
עבור מי שעובד בתעשייה כאן בישראל, השינוי הזה מרגיש מוכר: חברות כמו Nvidia בונות אקוסיסטם שקשה לצאת ממנו — בקטע טוב מבחינתן, ובמחיר שהשוק החופשי גובה ושכולנו מכירים. השאלה היחידה היא מי ירוויח מכך שהשרטוטים האלה פתוחים: יצרנים קטנים שיקצרו זמני פיתוח, או Nvidia עצמה שתרחיב את האחיזה שלה בכל שכבה.
התשובה, כנראה, היא גם וגם.